
Моды позволили вдвое ускорить тензорные ядра на GeForce RTX 2000, RTX 3000 и RTX 4000
МЕНЮ
Главная страница
ТЕМЫ
Новости ИИ
Городские сумасшедшие
ИИ в медицине
ИИ проекты
Искусственные нейросети
Искусственный интеллект
Слежка за людьми
Угроза ИИ
ИИ теория
Компьютерные науки
Машинное обуч. (Ошибки)
Машинное обучение
Машинный перевод
Нейронные сети начинающим
Психология ИИ
Реализация ИИ
Реализация нейросетей
Создание беспилотных авто
Трезво про ИИ
Философия ИИ
Генетические алгоритмы
Капсульные нейросети
Основы нейронных сетей
Промпты. Генеративные запросы
Распознавание лиц
Распознавание образов
Распознавание речи
Творчество ИИ
Техническое зрение
Чат-боты
Авторизация

2026-10-30 18:38

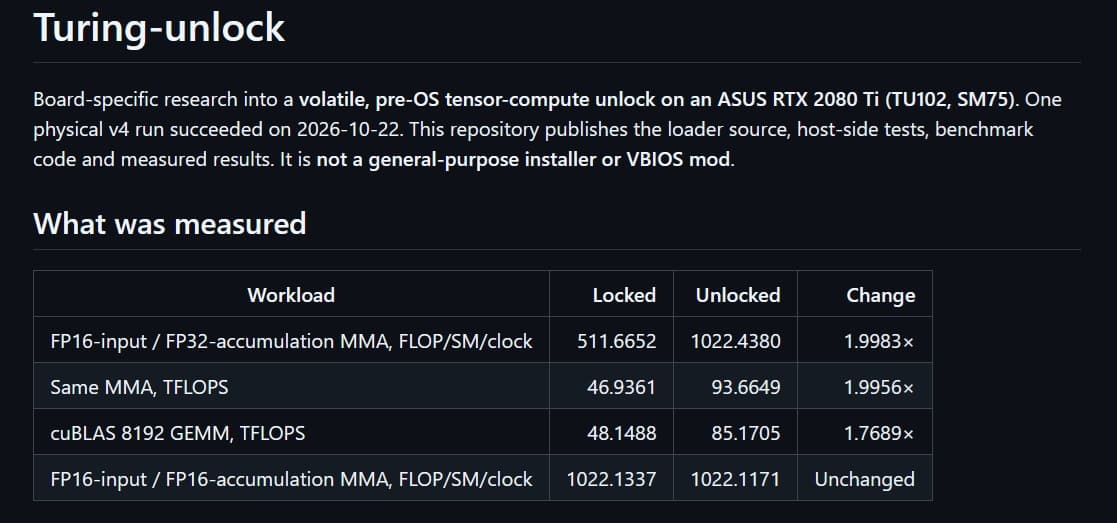
Энтузиасты нашли способ снять программные ограничения, которые NVIDIA накладывает на потребительские видеокарты GeForce, и до двух раз повысить скорость некоторых операций тензорных ядер. Началось всё с RTX 3090, затем дошло до моделей серии RTX 4000 и даже до не самой молодой RTX 2080 Ti. Главная особенность в том, что для этого не нужно ни паять, ни прошивать VBIOS.
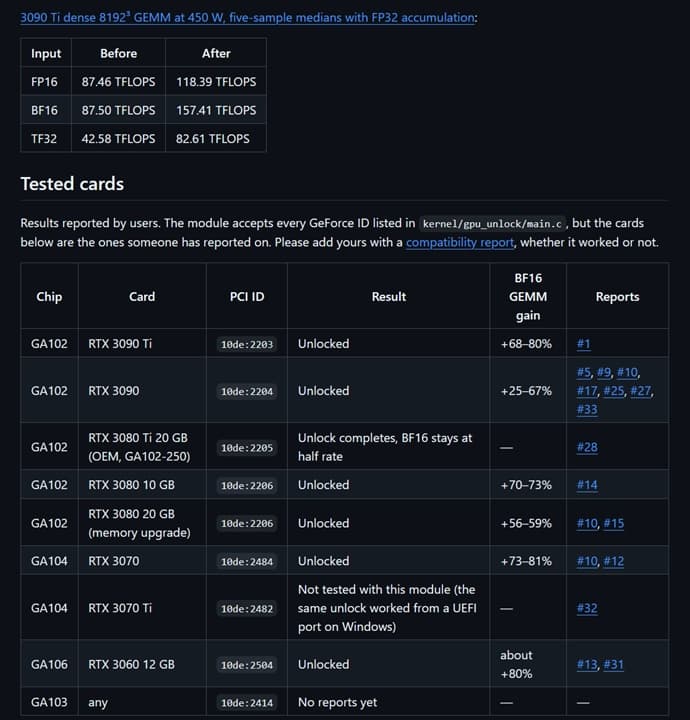
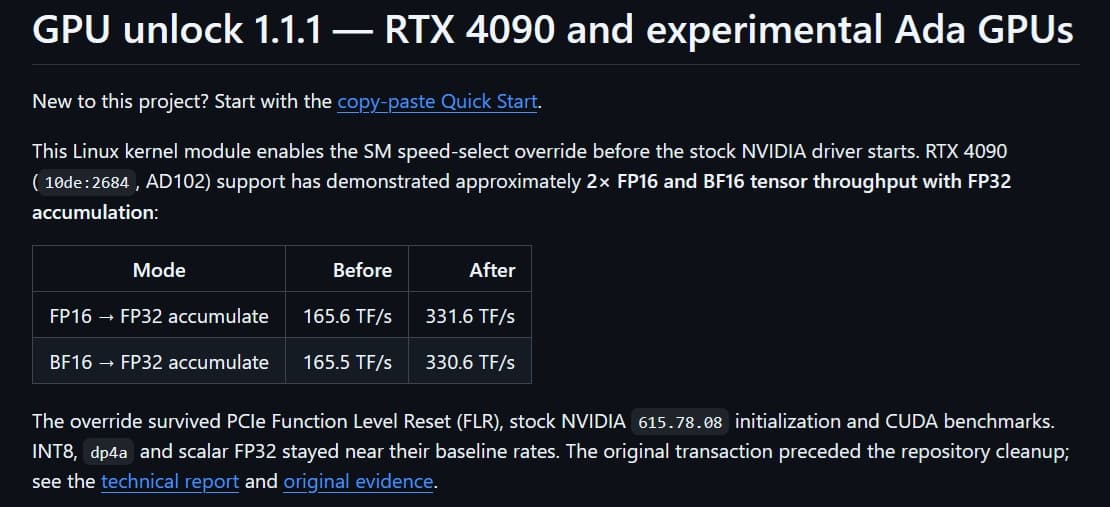
Для серии RTX 3000 разработчик Zagitta адаптировал существующие методы в открытом проекте GPU Unlock, который работает через модуль ядра Linux и меняет значения регистров ещё до загрузки драйвера. Поддержку архитектуры Ada Lovelace, то есть серии RTX 4000, добавил разработчик TOTORONG. И результаты впечатляют: RTX 4090 увеличила пропускную способность FP16 с 165.6 до 331.6 TFLOPS, а RTX 3090 Ti в BF16 выросла с 87.5 до 157.4 TFLOPS.
Теперь о неприятном: на игры это никак не влияет. Выигрыш есть только в вычислительных задачах, причём в реальных приложениях он куда скромнее теоретического. По данным тестов, RTX 3090 Ti в ComfyUI получила прирост 56-59% на моделях BF16, обработка запроса в языковых моделях ускорилась на 14-36%, а вот генерация токенов почти не изменилась, потому что упирается в пропускную способность памяти, а не в вычисления. Операции INT8 не ускорились вовсе.
Получается, что NVIDIA годами держала часть потенциала игровых видеокарт «в ограниченном режиме», чтобы работяги покупали именно профессиональные модели. Теперь же тем, кто запускает нейросети локально, остаётся только оценить риски, ведь способ экспериментальный.
Телеграм: t.me/ainewsline
Источник: i2hard.ru